Category: Banco de dados

  • Cache | Como Implementar o Cache para Melhorar o Desempenho

    Cache | Como Implementar o Cache para Melhorar o Desempenho

    Se você já teve que lidar com problemas de desempenho em aplicações web, provavelmente já ouviu falar em cache. E se ainda não ouviu, prepare-se: você vai ouvir 😅. Cache é um daqueles mecanismos simples na superfície, mas poderosos quando usados corretamente.

    Na prática, ele pode fazer sua aplicação voar. Isso, claro, se for bem configurado. Caso contrário, você pode acabar se perguntando por que está recebendo dados de três dias atrás quando deveria estar vendo informações atualizadas.

    Neste artigo, vamos explorar o que é cache, como ele funciona e, mais importante, como implementar cache de forma eficaz no Django (mas muitas dessas dicas se aplicam a qualquer framework ou linguagem). Vamos falar sobre as melhores práticas, armadilhas e, claro, quando não usar cache (spoiler: nem tudo deve ser cacheado).

    O que é Cache e Por Que Você Precisa Dele

    De forma simples, cache é uma maneira de armazenar dados que são frequentemente solicitados, de modo que eles possam ser recuperados rapidamente, sem precisar de novas consultas ao banco de dados ou outras operações demoradas.

    Em vez de processar novamente os dados toda vez que alguém faz uma requisição, você armazena o resultado pronto e entrega rapidamente quando necessário.
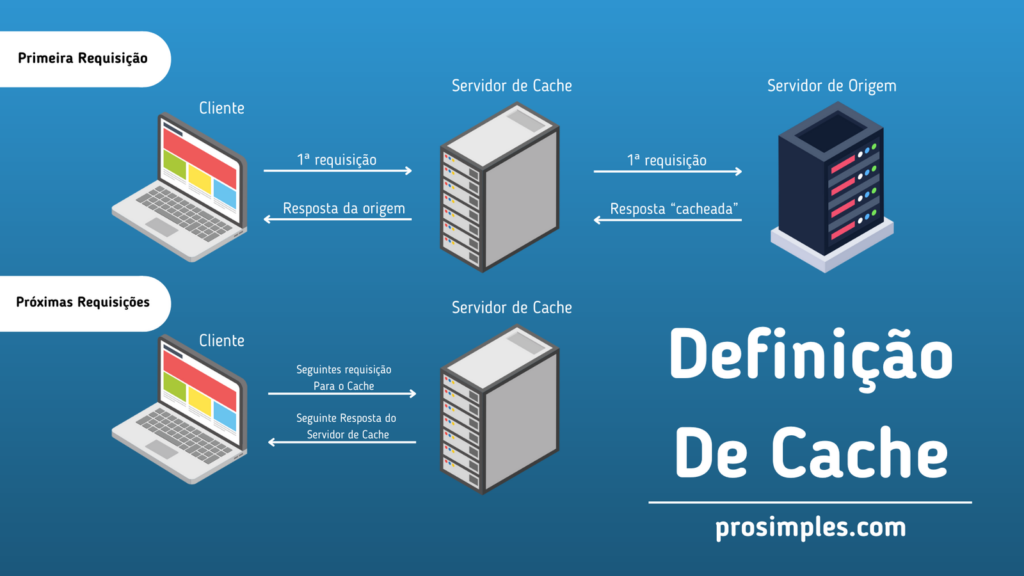
    definição de cache

    Cache é basicamente preguiça organizada, e a preguiça, aqui, é uma virtude. Afinal, se sua aplicação precisar refazer cálculos ou consultas longas toda vez que alguém carrega uma página, isso vai gerar uma carga desnecessária no servidor e no banco de dados. Com o cache, você evita esse trabalho repetitivo, guardando os resultados para reutilização.

    Aqui estão alguns exemplos de uso de cache:

    • Cache de páginas: Armazena uma versão completa da página web pronta para ser entregue ao navegador.
    • Cache de fragmentos: Armazena partes específicas de uma página que demoram mais para serem geradas (ex.: blocos de dados complexos, gráficos, etc.).
    • Cache de consultas ao banco de dados: Armazena os resultados de consultas SQL para evitar que a mesma consulta seja repetida várias vezes.

    Tipos de Cache

    Nem todo cache é criado da mesma forma. Há diferentes tipos de cache, cada um com suas próprias vantagens e desvantagens. Vamos dar uma olhada nos tipos mais comuns.

    Cache de Memória

    O cache de memória é o tipo mais simples de cache. Ele armazena dados diretamente na RAM do servidor. Como a RAM é muito mais rápida que o disco rígido ou que acessar dados por meio de uma rede, o cache em memória pode oferecer um aumento substancial de desempenho.

    No entanto, esse tipo de cache é limitado à quantidade de memória disponível no servidor. Além disso, em ambientes distribuídos (com vários servidores), o cache em memória não é compartilhado entre as instâncias, o que pode gerar inconsistências.

    Exemplo: Memcached

    Memcached é uma solução de cache em memória distribuída. Ele é extremamente rápido e eficiente para armazenar pequenos pedaços de dados em memória, como resultados de consultas ou partes de páginas. Memcached funciona bem em sistemas com várias instâncias de servidor, pois seu cache é compartilhado entre elas.

    Cache Distribuído

    Em sistemas de grande escala, o cache distribuído é uma solução que permite armazenar dados em um ambiente centralizado, acessível por todas as instâncias do servidor. Isso garante que, independentemente de quantos servidores você tenha, todos podem acessar e compartilhar os mesmos dados de cache.

    Exemplo: Redis

    Redis é um sistema de armazenamento de dados em memória que funciona como um cache distribuído. Ele é rápido, suporta estruturas de dados mais complexas que o Memcached (como listas, hashes e conjuntos) e é persistente, o que significa que, se o servidor Redis cair, você não perde os dados armazenados nele.

    Implementando Cache em Django

    Agora que você sabe o que é cache e os tipos mais comuns, vamos ver como implementá-lo em um projeto Django. O Django oferece várias opções de cache embutidas, e configurar o cache em um projeto Django é relativamente simples.

    Configurando o Cache no Django

    Antes de começarmos a cachear tudo que vemos pela frente, vamos configurar o cache no Django. O Django suporta diferentes backends de cache, como o Memcached e o Redis, mas também pode usar o sistema de arquivos ou até mesmo o cache em memória local (útil para desenvolvimento).

    Para começar, abra o arquivo settings.py e configure o backend de cache. Um exemplo usando Memcached:

    CACHES = {
        'default': {
            'BACKEND': 'django.core.cache.backends.memcached.MemcachedCache',
            'LOCATION': '127.0.0.1:11211',
        }
    }
    Python

    Ou, se preferir Redis:

    CACHES = {
        'default': {
            'BACKEND': 'django.core.cache.backends.redis.RedisCache',
            'LOCATION': 'redis://127.0.0.1:6379/1',
        }
    }
    Python

    Cache de Página no Django

    Uma das maneiras mais simples de implementar cache no Django é através do cache de página. Ele funciona armazenando a saída completa de uma view e reutilizando-a para futuras requisições.

    Aqui está como você pode aplicar o cache de página em uma view:

    from django.views.decorators.cache import cache_page
    
    @cache_page(60 * 15)  # Cache por 15 minutos
    def minha_view(request):
        # Lógica da view
        pass
    Python

    Com essa simples linha, a saída dessa view será armazenada em cache por 15 minutos. Durante esse período, qualquer requisição para essa view será respondida diretamente a partir do cache, sem executar a lógica da view novamente.

    Cache de View

    Se você tem uma view mais complexa e não quer cachear a página inteira, pode optar por cachear partes dela. Isso é chamado de cache de fragmento. Aqui está um exemplo de como usar isso em templates:

    {% load cache %}
    
    {% cache 600 bloco_popular %}
        <!-- Conteúdo do bloco que deve ser cacheado -->
        <div>
            <h2>Posts Popularesh2>
            {% for post in posts_populares %}
                <p>{{ post.title }}p>
            {% endfor %}
        div>
    {% endcache %}
    Python

    Nesse exemplo, o bloco de posts populares será armazenado em cache por 600 segundos (10 minutos). O restante da página será renderizado normalmente, mas esse trecho específico será servido do cache.

    Cache de Querysets

    Outro uso comum de cache no Django é armazenar os resultados de consultas ao banco de dados. Imagine que você tem uma consulta pesada que é executada em várias views. Em vez de refazer essa consulta toda vez, você pode armazenar os resultados em cache.

    from django.core.cache import cache
    
    def minha_view(request):
        posts = cache.get('posts_populares')
        if not posts:
            posts = Post.objects.filter(popular=True)
            cache.set('posts_populares', posts, timeout=60*15)
        return render(request, 'minha_template.html', {'posts': posts})
    Python

    Aqui, estamos tentando recuperar os posts populares do cache. Se eles não estiverem no cache, fazemos a consulta e armazenamos os resultados.

    Usando Redis como Cache no Django

    Redis é uma excelente escolha para cache distribuído em projetos Django. Ele é rápido, suporta TTL (tempo de vida) e é muito fácil de configurar.

    Passo 1: Instalando o Redis

    Primeiro, instale o Redis no seu sistema. No Ubuntu, você pode fazer isso com:

    sudo apt-get install redis-server
    Python

    Depois, instale o pacote Python para integração com o Redis:

    pip install django-redis
    Python

    Passo 2: Configurando Redis no Django

    Agora, configure o backend de cache do Redis no settings.py:

    CACHES = {
        'default': {
            'BACKEND': 'django_redis.cache.RedisCache',
            'LOCATION': 'redis://127.0.0.1:6379/1',
            'OPTIONS': {
                'CLIENT_CLASS': 'django_redis.client.DefaultClient',
            }
        }
    }
    Python

    Passo 3: Usando o Cache Redis

    Depois de configurar o Redis, o uso de cache segue os mesmos princípios que vimos anteriormente. O Redis cuida da persistência e distribuição, enquanto o Django gerencia o cache de forma transparente.

    Quando NÃO Usar Cache

    Cache parece uma ferramenta mágica, mas, como todas as boas ferramentas, não deve ser usada indiscriminadamente. Aqui estão alguns casos onde o uso de cache pode ser uma má ideia:

    • Dados sensíveis ou altamente dinâmicos: Nunca armazene em cache dados que mudam com frequência ou que são específicos do usuário, como informações de perfil, carrinho de compras ou páginas com informações financeiras.
    • Quando o custo de cachear for maior que o benefício: Cachear consultas simples que retornam rapidamente pode ser um desperdício de recursos.
    • Para operações de gravação: Não faz sentido cachear operações que envolvem a criação ou modificação de dados, já que o cache seria invalidado imediatamente.

    Cache Expirado: Controlando a Validade

    O TTL (Time-to-Live) é o tempo que um item de cache deve ficar armazenado antes de ser considerado “expirado” e removido. Controlar a validade do cache é essencial para garantir que os usuários sempre recebam dados atualizados.

    Ao configurar o cache no Django, você pode definir um timeout para cada item armazenado:

    cache.set('chave', valor, timeout=60*5)  # Expira em 5 minutos
    Python

    O Redis também suporta políticas de remoção, como LRU (Least Recently Used), que remove itens menos utilizados quando o cache está cheio.

    Melhorando o Desempenho com Cache

    A melhor maneira de garantir que o cache esteja realmente melhorando o desempenho é medir. Use ferramentas como o Django Debug Toolbar ou o New Relic para monitorar o impacto do cache no desempenho da aplicação. Meça antes e depois de aplicar o cache, e sempre ajuste o tempo de validade e os elementos que você está cacheando.

    Um cache bem configurado pode reduzir significativamente o tempo de resposta das páginas e o número de consultas ao banco de dados. No entanto, cachear de forma inadequada pode não gerar os ganhos esperados, ou pior, criar problemas como cache sujo (dados desatualizados sendo entregues ao usuário).

    Conclusão

    Implementar cache é uma das maneiras mais eficazes de melhorar o desempenho de uma aplicação web, especialmente em sistemas que lidam com grandes volumes de tráfego e dados. No entanto, é fundamental saber o que e quando cachear para evitar problemas como dados desatualizados ou cache ineficiente.

    Neste artigo, exploramos os diferentes tipos de cache, desde soluções em memória até caches distribuídos como Redis. Mostramos como implementar cache no Django com exemplos práticos de código, além de discutirmos armadilhas comuns e boas práticas.

    Agora, é hora de aplicar esses conceitos no seu projeto e ver como o cache pode transformar o desempenho da sua aplicação. Mas lembre-se: cache é bom, mas usá-lo com moderação é ainda melhor.
  • Mapeamento objeto-relacional (ORM) Em Operações De Banco De Dados

    Mapeamento objeto-relacional (ORM) Em Operações De Banco De Dados

    Como desenvolvedor, simplificar as interações do banco de dados (como o uso de ORM), mantendo a eficiência, é crucial.

    Sem mencionar que, em alguns casos, devemos nos concentrar em entregar o produto rapidamente, sem muitas abstrações, e criar um ORM pode remover essa camada de complexidade para focar no produto em si.

    Portanto, hoje, vamos nos aprofundar na criação de um ORM, uma ferramenta poderosa que agiliza as operações do banco de dados, encapsulando-as em classes e métodos intuitivos.

    Criação da classe e inicialização do ORM:

    O método __init__ inicializa o ORM estabelecendo uma conexão com o banco de dados SQLite usando o módulo sqlite3.

    import sqlite3
    
    class SimpleORM:
    
      def __init__(self, db_name):
        self.conn = sqlite3.connect(db_name)
        self.cursor = self.conn.cursor()
    Python

    Além disso, adicionando uma nova variável que permite a criação de consultas neste banco de dados já conectamos.

    Iniciando uma nova conexão com o banco de dados via ORM:

    Nessa abordagem, estabelecemos uma conexão com o banco de dados usando a classe SimpleORM, permitindo a execução de várias consultas dentro do banco de dados especificado.

    Como é evidente, o ‘db.sqlite3‘ representa o caminho do arquivo onde o banco de dados está localizado, designado dentro do método sqlite3.connection() para estabelecimento da conexão.

    Criando tabelas com o método create_table na ORM:

    O método create_table habilita a criação de tabelas dentro do banco de dados. Ele recebe parâmetros para table_name e colunas, executando a consulta SQL para criar a tabela se ela ainda não existir.

    def create_table(self, table_name, columns):
      self.cursor.execute(f"CREATE TABLE IF NOT EXISTS {table_name} ({columns})")
      self.conn.commit()
    Python

    Portanto, usar essa abordagem pode facilitar a criação de uma tabela simples com a redução de pequenas melhorias, mas sem muita complicação.

    Criando uma nova tabela com o método create_table:

    # Create a table with an auto-incremental ID
    orm.create_table("users", "id INTEGER PRIMARY KEY AUTOINCREMENT, name TEXT, age INTEGER")
    Python

    Neste cenário, há alterações mínimas necessárias para a criação da tabela. No entanto, algumas intricadas e complexidades de consultas SQL, como definições de nomes de colunas. Elas podem ser simplificadas pela introdução de um BaseModel. (Vou me aprofundar mais nessa abordagem em um próximo post).

    Inserindo dados na tabela criada usando o método insert_data:

    O método insert_data insere dados na tabela especificada. Ele gera dinamicamente a consulta SQL, inserindo dados passados ​​como argumentos na tabela designada.

    # Os outros metodos acima....
    
    def insert_data(self, table_name, **kwargs):
      columns = ", ".join(kwargs.keys())
      placeholders = ", ".join(["?"] * len(kwargs))
      query = f"INSERT INTO {table_name} ({columns}) VALUES ({placeholders})"
      values = tuple(kwargs.values())
      self.cursor.execute(query, values)
      self.conn.commit()
    Python

    A propósito, como funciona? O método insert_data() cria dinamicamente uma consulta SQL INSERT gerando nomes de colunas e espaços reservados para valores com base no nome da tabela e argumentos de palavra-chave fornecidos.

    Em seguida, ele executa essa consulta para inserir dados na tabela especificada usando o cursor, confirmando as alterações no banco de dados posteriormente.

    Esse método permite a inserção flexível de dados em tabelas sem especificar explicitamente nomes de colunas na consulta, aproveitando os argumentos de palavra-chave fornecidos como pares coluna-valor.

    Como usar o método insert_data():

    # Insert data (ID é auto-incrementado)
    orm.insert_data("users", name="John", age=32)
    orm.insert_data("users", name="Maria", age=22)
    Python

    Neste exemplo foram utilizadas duas consultas para adicionar duas linhas dentro da tabela users.

    Lendo dados de uma tabela específica com o método read_data():

    # Os outros metodos acima....
    
    def read_data(self, table_name):
      self.cursor.execute(f"SELECT * FROM {table_name}")
      return self.cursor.fetchall()
    Python

    O método read_data() é simples, até agora ele só lê todos os dados de uma tabela específica. Basicamente, é similar a TableName.objects.all() usando o Django ORM.

    Usando o método read_data():

    # Ler e print data
    data = orm.read_data("users")
    print("Data:", data)
    
    # Resultado ---
    # Data: [(1, 'John', 32), (2, 'Maria', 22)]
    Python

    Este é o resultado do metodo read_data().

    Atualizando linhas dentro de tabelas específicas usando o método update_data():

    # Os outros metodos acima....
    
    def update_data(self, table_name, id, **new_data):
      set_values = ", ".join([f"{key} = ?" for key in new_data.keys()])
      query = f"UPDATE {table_name} SET {set_values} WHERE id = ?"
      values = tuple(new_data.values()) + (id,)
      self.cursor.execute(query, values)
      self.conn.commit()
    Python

    O método update_data() é um pouco mais complexo, pois precisa atualizar uma linha específica dentro de uma tabela. Usando os argumentos kword para criar a consulta dinamicamente.

    Usando o metodo updated_data():

    # Update data
    orm.update_data("users", id=1, name="Alicy", age=27)
    updated_data = orm.read_data("users")
    print("Updated Data:", updated_data)
      
    # Resultado ---
    # Data: [(1, 'Alicy', 27), (2, 'Maria', 22)]
    Python

    Aqui está o método update_data() em ação. Seguindo a implementação acima, ele obtém as chaves dos novos valores dos argumentos (id, name, age) para inseri-los no lugar dos dados antigos na consulta. Além disso, os valores (1, ‘Alicy’ e 27) são inseridos como tupla na variável values, após a consulta ser executada no banco de dados.

    Excluindo dados de uma tabela específica usando o método delete_data():

    # Os outros metodos acima....
    
    def delete_data(self, table_name, id):
      query = f"DELETE FROM {table_name} WHERE id = ?"
      self.cursor.execute(query, (id,))
      self.conn.commit()
    Python

    O método delete_data() não é um método muito complexo deste exemplo de ORM. Basicamente, ele recebe dois parâmetros, como table_name e id, os insere na consulta DELETE, executa e confirma o código no banco de dados.

    Entenda mais sobre ORM nesta postagem.

    Usando o método delete_data():

    # Delete data
    orm.delete_data("users", id=3)
    new_data = orm.read_data("users")
    print("Dados depois de deletar id especifico:", new_data)
    
    # Resultado ---
    # Dados depois de deletar id especifico: [(2, 'Maria', 22)]
    Python

    Este é um exemplo do metodo delete_data().

    Como o codigo ficara finalizado:

    import sqlite3
    
    class SimpleORM:
        def __init__(self, db_name):
            self.conn = sqlite3.connect(db_name)
            self.cursor = self.conn.cursor()
    
        def create_table(self, table_name, columns):
            self.cursor.execute(f"CREATE TABLE IF NOT EXISTS {table_name} ({columns})")
            self.conn.commit()
    
        def insert_data(self, table_name, **kwargs):
            columns = ", ".join(kwargs.keys())
            placeholders = ", ".join(["?"] * len(kwargs))
            query = f"INSERT INTO {table_name} ({columns}) VALUES ({placeholders})"
            values = tuple(kwargs.values())
            self.cursor.execute(query, values)
            self.conn.commit()
    
        def read_data(self, table_name):
            self.cursor.execute(f"SELECT * FROM {table_name}")
            return self.cursor.fetchall()
    
        def update_data(self, table_name, id, **new_data):
            set_values = ", ".join([f"{key} = ?" for key in new_data.keys()])
            query = f"UPDATE {table_name} SET {set_values} WHERE id = ?"
            values = tuple(new_data.values()) + (id,)
            self.cursor.execute(query, values)
            self.conn.commit()
    
        def delete_data(self, table_name, id):
            query = f"DELETE FROM {table_name} WHERE id = ?"
            self.cursor.execute(query, (id,))
            self.conn.commit()
    
        def close_connection(self):
            self.conn.close()
    
    # Example usage:
    if __name__ == "__main__":
        orm = SimpleORM("db.sqlite3")
    
        # Create a table with an auto-incremental ID
        orm.create_table("users", "id INTEGER PRIMARY KEY AUTOINCREMENT, name TEXT, age INTEGER")
    
        # Insert data (ID is auto-incremented)
        orm.insert_data("users", name="John", age=32)
    
        # Read and print data
        data = orm.read_data("users")
        print("Data:", data)
    
        # Update data
        orm.update_data("users", id=1, name="Alicy", age=27)
        updated_data = orm.read_data("users")
        print("Updated Data:", updated_data)
    
        # Delete data
        orm.delete_data("users", id=3)
        new_data = orm.read_data("users")
        print("Data after deletion:", new_data)
    
        # Close the connection
        orm.close_connection()
    Python

    Conclusão

    Em resumo, este ORM exemplifica uma implementação direta dos princípios DRY. Ao utilizar esta abordagem, os desenvolvedores podem reduzir significativamente a complexidade do código e minimizar o número de consultas.

    No entanto, enquanto um ORM simplifica o código e reduz a repetição, esta implementação em particular permanece relativamente simplista em comparação com ORMs mais estabelecidos.

    Por exemplo, ele necessita da inclusão de um BaseModel para criar tabelas inteiramente via código Python. E não tem capacidades para estabelecer relacionamentos de tabela. Ou filtrar dados com base em valores específicos além de retornar todas as linhas.

    No entanto, esta demonstração serve como um vislumbre perspicaz do funcionamento interno dos ORMs em relação às operações de banco de dados.

  • Noções Basicas de Models no Django e Como Usá-los Para Interagir Com o Banco de Dados.

    Noções Basicas de Models no Django e Como Usá-los Para Interagir Com o Banco de Dados.

    Django models são simplemente a definição e representação de dados em uma aplicação Django.

    Com isso, caso você queira trabalhar e implementar interações com algum banco de dados e essencial que você entenda como trabalhar com essa ferramenta no qual ira te ajudar muito no seu desenvolvimento.

    Vamos lá! Irei explicar sobre os models do django de uma forma simplificada, no qual esperofacilitar o seu entendimento.

    Ok, mas o que são django models de uma forma mais técnica?

    Bem, se você ja tem uma noção do que é um banco de dados relacional. Onde existem tabelas especificas que se pode se inserir dados, ficará muito facil te explicar.

    No caso, os models do Django são usados para criar e representar tabelas de um banco de dados como objetos em Python.

    Em outras palavras, você poderá criar um model no Django (que representa uma tabela) herdando uma classe do Django chamada Model.

    Como cada tabela de um banco de dados tem tipos de campos diferentes, você também poderá aplicar essa tipificação aos campos da mesma maneira, porém utilizando o Django.

    Exemplo de uma tabela simples no SQL:

    idtitulodescricao
    1Como fazer molho de tomate caseiroNessa postagem iremos falar sobre um dos…
    210 maneiras de criar massas de pizza caseiraVoce ira aprender quais são as dez maneira…
    3Quais os melhores sistemas de restauranteTrabalhando a 15 anos como gestor de resta..
    Tabela: Postagens

    Agora, como uma tabela seria representada em uma aplicação Django?

    from django.db import models # <-- Herdando toda a lógica pronta do Django
    
    class Postagen(models.Model):
        titulo = models.CharField(max_length=120)
        descricao = models.TextField()
        
        def __str__(self):
          return self.titulo
    Python

    Como podemos notar, temos uma tabela (vamos dizer que é uma tabela em um banco de dados 😄) chamada Postagens. Logo abaixo, temos um model no Django que representa essa tabela com o mesmo número de colunas: título e descrição.

    Ah, só para lembrar que, no Django, não é necessário adicionar o campo ID. Ele é adicionado por padrão nos modelos do Django. 😉

    Dessa forma, com uma explicação um pouco mais técnica que a introdução, você já consegue entender melhor qual é o propósito inicial de um model no Django.

    Campos Comuns Usados em Modelo do Django

    Como existem vários tipos de dados para colunas em um banco de dados, como strings, caracteres, booleanos, numéricos (inteiros, flutuantes e especiais), etc., no próprio model do Django você terá a possibilidade de criar diferentes colunas com diferentes tipos de dados.

    No exemplo acima, vemos duas colunas: título e descrição. Essas duas colunas têm tipos de dados praticamente iguais: CharField() e TextField().

    O CharField traz a capacidade de criar textos com um número limitado de caracteres (no exemplo acima, com 120 caracteres) e será traduzido como VARCHAR no banco de dados.

    Já o TextField é basicamente a representação de uma string, sem limitação de caracteres, e será traduzido como TEXT no banco de dados.

    Além dessas existe uma gama de campos usados em models no Django.

    Porém as mais comuns são os campos:

    1. Para textos temos os CharField (cujo e obrigatorio usar o parametro max_length) e o TextField.
    2. Tipo numéricos temos o IntegerField (que armazena numeros inteiros), FloatField e o DecimalField que tambem adiciona numeros flutuantes porem com casas decimais definidas como a adição de casas decimais com o parametro decimal_places, e o numero total de digitos com o parametro max_digits.
    3. Também temos campos que representam data e hora. Com os campos, DateField que apenas armazena (ano, mes e dia). O TimeField que apenas armazena horas e o DateTimeField que armazen data e horas.
    4. Alem disso também temos campos do tipo booleanos como o BooleanField no qual e usado para adicionar valores como True ou False.
    5. E por fim, temos os campos de relacionamentos: ForeignKey onde se cria um relacionamento de “muitos para um” onde se é necessario adicionar para qual tabela ou modelo esta sendo relacionado e o parametro on_delete no qual será setado o que acontecerá ao deletar a row com o relacionamento. O campo de relacionamento OneToOneField no qual cria um relacionamento de “um para um” entre duas tabelas. E por fim o campo de relacionamento ManyToManyField que criar relacionamentos de “mutos para muitos” entre duas tabelas.

    Os campos citados acima são apenas os mais comuns usados para a criação de um model no django. Existem varios outros no qual voce pode pesquisar para uso mais especificos e tambem pode ate criar um campo especifico para seu uso especifico, porem eu não irei entrar em muitos detalhes nesta postagem.

    Conectando com bancos de dados em uma aplicação django

    Antes de iniciar qualquer explicação aqui sobre a criação de objetos usando a ORM do django através dos models, ficaria sem sentido fazer isso sem a explicação da conexão de uma aplicação django com um banco de dados. Com isso explicarei brevemente como uma conexão do django e feita com o banco de dados:

    Por padrão o django tem um arquivo de configuração chamado settings.py onde vários arquivos de conexão e configurações estão alocadas, e uma delas é a conexão com o banco de dados.

    # settings.py
    
    DATABASES = {
        "default": {
            "ENGINE": "django.db.backends.sqlite3",
            "NAME": "mydatabase",
        }
    }
    Python

    No código acima podemos ver qual é a constante que representa a conexão com o banco de dados chamada DATABASES. Neste exemplo é representado com uma configuração padrão de uma aplicação inicial do Django.

    Por outro lado, também podemos usar esta mesma constante para se conectar com diferente bancos de dados:

    # settings.py
    
    DATABASES = {
        "default": {
            "ENGINE": "django.db.backends.postgresql",
            "NAME": "mydatabase",
            "USER": "mydatabaseuser",
            "PASSWORD": "mypassword",
            "HOST": "127.0.0.1",
            "PORT": "5432",
        }
    }
    Python

    Com o exemplo acima criando a conexão com um banco de dados “ENGINE” postgresql e suas variaveis necessarias para conexão.

    Migrando as Tabelas

    Quando você define os models (modelos de dados) no Django, eles ainda não existem no banco de dados. Para criar as tabelas no banco, você usa o comando python manage.py migrate. O Django então traduz os models em tabelas SQL e as cria no banco de dados.

    Realizando a Conexão

    Quando você executa o Django (comandos como runserver ou migrate), o Django usa essas informações para se conectar ao banco de dados. Ele cria uma conexão automática por meio de sua camada de abstração de banco de dados, chamada ORM (Object-Relational Mapping). Com o ORM, o Django traduz o código Python em consultas SQL para interagir com o banco de dados.

    Interagindo com o Banco de Dados

    Com a conexão estabelecida, o Django permite que você faça operações como criar, ler, atualizar e deletar registros no banco de dados usando código Python. Basicamente, Você não precisa escrever consultas SQL manualmente, o Django faz isso por você com seu ORM.

    Passo-a-passo de iteração com banco de dados usando django models e ORM

    Vamos supor que iremos criar uma aplicação django onde iremos adicionar postagens (da mesma maneira que fizemos no topo desta postagem). Porém iremos usar esta tabela para iteragir com o banco de dados.

    # models.py
    from django.db import models
    from django.contrib.auth.models import User
    
    class Postagem(models.Model):
        titulo = models.CharField(max_length=120)
        descricao = models.TextField()
        data_criacao = models.DateField(auto_now_add=True)
        autor = models.ForeignKey(User, on_delete=models.DO_NOTHING)
        
        def __str__(self):
            return self.titulo
    Python

    Ao criar esta tabela devemos rodar o comando:

    python manage.py makemigrations # cria um arquivo de migrations
    python manage.py migrate # reflete o model no banco de dados
    Bash

    Ao ativar os dois comandos acima, por padrão, será criado um banco de dados sqlite3 no django (em caso você não fazer conexão com outro banco de dados). É refletida todas as migrations padrão do django e a desse modelo para o banco de dados.

    Interagindo Com o Banco de Dados Usando ORM do Django

    Agora que temos toda configuração feita podemos testar nosso modelo de postagens em usuarios usando o ORM do django.

    No terminal adicione o seguinte comando:

    python manage.py shell
    Bash

    Com isso voce terá acesso ao shell da aplicação django que voce esta trabalhando. Então se tudo correu bem você terá acesso ao shell da aplicação como a seguir:

    (venv) C:\software_projects\projeto_de_configuração> python manage.py shell
    Python 3.10.11 (...) [MSC v.1929 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    (InteractiveConsole)
    >>> # seu codigo ira ser adicionado aqui
    Bash

    Agora vamos iniciar a criação dos dados usando os models que criamos e a ORM do django.

    >>> # imports
    >>> from postagens.models import Postagem       
    >>> from django.contrib.auth.models import User
    >>> 
    >>> # criação de usuario --
    >>> user = User.objects.create(username="Elias", password="Aprendendo123")
    >>> 
    >>> # testando se usuario foi criado
    >>> user
    <User: Elias>
    >>>
    >>> # criacao de postagem --
    >>> postagem = Postagem.objects.create(
    ... titulo="Noções Basicas de Models no Django..",
    ... descricao="Models é simplemente a definição e representação de dados em...",
    ... autor=user
    ... )
    >>> # checagem se a postagem foi criada
    >>> postagem
    <Postagem: Noções Basicas de Models no Django..>
    >>>
    >>> # checagem de campos.     
    >>> postagem.autor
    <User: Elias>
    >>> postagem.data_criacao
    datetime.date(2024, 9, 27)
    >>>
    Python

    Como vemos acima, usamos um sub-framework do Django ORM para interagir com o banco de dados. Explicando o que foi feito: assim que entrei no shell com o comando python manage.py shell, fiz o import dos models que irei usar, o model Postagem e o User (que é padrão do Django).

    Em seguida, foi usado o comando para criar um único usuário com apenas username e password. Só para lembrar que foi criado o usuário porque seria necessário para a criação de uma postagem.

    Sem um usuário, não seria possível criar uma postagem. Dessa forma, a postagem foi criada, associando o usuário criado anteriormente ao campo autor.

    Por último, foi verificado se a postagem havia sido criada corretamente, também checando os campos como postagem.autor e postagem.data_criacao.

    Checando Os Dados Diretamente No Banco de Dados

    Caso você esteja usando o VSCode, poderá instalar uma extensão chamada SQLite Viewer.

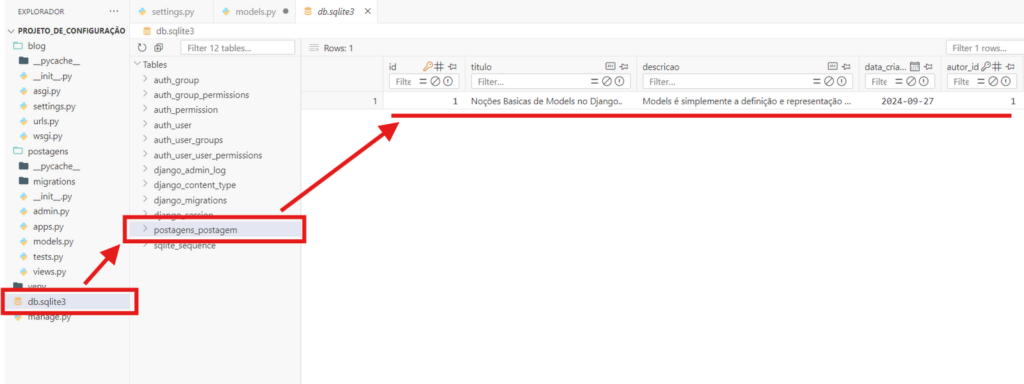
    Com essa extensão você poderá acessar o banco de dados de teste sqlite clicando no icone do sqlite para acessar os dados que foram criados usando os comandos do shell.

    Como voce vê acima, para visualizar as tabelas criadas você poderá seguir os passos que foram feitos acima (logo após você instalar o SQLite Viewer).

    1. Então nesse caso, você poderá iniciar clicando no icone do banco db.sqlite3.
    2. Ja na sequência você terá acesso a todas as tabelas que existem no sistema.
    3. Ache a tabela que precisa saber onde estão os dados criados (lembrando que o django segue um padrão de nomeação de tabelas (<app-name>_<model-name>)). Então nesse caso precisa-se clicar em postagens_postagem.
    4. Ao clicar na tabela você terá o acesso aos dados que você criou com os dados como id, titulo, descricao, data_criacao e autor_id.

    Conclusão

    Nesta postagem poderia ser explicado tudo que sei sobre ORM, como criação de diferente relacionamentos, criação de campos customizaveis ou até mesmo te explicar outros tipos de campos como o JSONField() porém o foco é você entender as noções basicas de models no django.

    Nesta postagem eu gostaria apenas de te apresentar como podemos trabalhar com models de uma forma simples e se conectar com o banco, criando alguns objetos, com inserção dos dados no banco de dados.

    Caso você precise de uma postagem mais complexa futuramente irei iniciar uma postagem com detalhes a fundo de django ORM, olhando por de baixo do capô do django e entendendo como esse framework funciona por de baixo dos panos.

  • Conceitos Básicos de Banco de Dados

    Conceitos Básicos de Banco de Dados

    Banco de dados desempenham um papel essencial no desenvolvimento web, proporcionando uma estrutura organizada para armazenar e gerenciar dados de forma eficiente.

    Eles servem como repositórios que oferecem não apenas armazenamento, mas também a capacidade de recuperar, atualizar e manipular informações de maneira estruturada.

    Em sua essência, um banco de dados é um sistema organizado para coletar, armazenar e gerenciar dados. No contexto do desenvolvimento web, isso significa que informações cruciais para o funcionamento de uma aplicação podem ser mantidas de maneira estruturada, facilitando a recuperação e manipulação quando necessário.

    Ao contrastar este uso com abordagens mais rudimentares, como armazenamento em arquivos, destacam-se as suas vantagens. Enquanto os arquivos podem atender a necessidades simples.

    Eles carecem da eficiência, escalabilidade e recursos de consulta oferecidos por sistemas de bancos de dados. Bancos de dados fornecem uma abordagem mais robusta para lidar com dados em aplicações web, permitindo maior flexibilidade e desempenho otimizado.

    Modelo Relacional

    O modelo relacional é a espinha dorsal dos sistemas de bancos de dados modernos, oferecendo uma estrutura organizada para armazenar e recuperar dados de maneira eficiente. Nesse modelo, os dados são organizados em tabelas, estabelecendo relações claras entre diferentes conjuntos de informações.

    Componentes Fundamentais de banco de dados:

    • Tabelas: As tabelas são entidades-chave no modelo relacional, servindo como recipientes para dados relacionados. Cada tabela é composta por colunas e linhas, onde as colunas representam atributos específicos e as linhas contêm entradas individuais associadas a esses atributos.
    • Registros: Registros são as entradas individuais em uma tabela. Cada linha em uma tabela é um registro que contém informações específicas sobre um conjunto de dados. Por exemplo, em uma tabela de clientes, cada linha pode representar um cliente individual.
    • Campos: Campos são as unidades individuais de dados em uma tabela. Cada coluna em uma tabela é um campo que representa um atributo específico. Continuando com o exemplo da tabela de clientes, os campos podem incluir nome, endereço, e-mail, entre outros.

    O modelo relacional proporciona uma abordagem clara e eficiente para organizar dados, permitindo relacionamentos significativos entre diferentes conjuntos de informações como tabelas. Essa estrutura é fundamental para a integridade e eficácia dos sistemas de bancos de dados utilizados no desenvolvimento web.

    SQL – Linguagem de Consulta Estruturada

    SQL, ou Linguagem de Consulta Estruturada, desempenha um papel crucial na interação com bancos de dados relacionais. Esta linguagem fornece uma maneira padronizada e eficaz de realizar consultas, manipular dados e gerenciar a estrutura do banco de dados.

    Principais Comandos SQL:

    • SELECT: O comando SELECT é utilizado para recuperar dados de uma ou mais tabelas. Ele permite especificar quais colunas devem ser recuperadas, aplicar condições para filtrar resultados e até mesmo combinar informações de tabelas diferentes. Por exemplo:
    SELECT nome, idade FROM clientes WHERE cidade = 'São Paulo';
    SQL
    • INSERT: O comando INSERT adiciona novos registros a uma tabela. Ao utilizar este comando, é possível inserir dados específicos para cada coluna, garantindo que as informações sejam registradas corretamente. Exemplo:
    INSERT INTO produtos (nome, preço) VALUES ('Notebook', 2500.00);
    SQL
    • UPDATE: Quando é necessário modificar dados existentes em uma tabela, o comando UPDATE é empregado. Pode-se atualizar valores em colunas específicas com base em condições definidas. Exemplo:
    UPDATE funcionários SET cargo = 'Gerente' WHERE id = 101;
    SQL
    • DELETE: O comando DELETE remove registros de uma tabela. Esteja ciente de que seu uso deve ser cauteloso, pois ele apaga dados de forma permanente. Exemplo:
    DELETE FROM pedidos WHERE status = 'Cancelado';
    SQL

    A compreensão desses comandos SQL fundamentais é essencial para qualquer desenvolvedor web que trabalhe com bancos de dados relacionais, pois eles formam a base para a manipulação eficaz dos dados armazenados.

    Chaves Relacionais de Banco de Dados

    As chaves desempenham um papel fundamental na modelagem de dados em bancos relacionais. Elas oferecem uma maneira de estabelecer conexões significativas entre diferentes tabelas, proporcionando integridade e eficiência na organização dos dados.

    Tipos de chaves relacionais:

    • Chave Primária (Primary Key): Uma chave primária é única para cada registro em uma tabela. Ela serve como identificador exclusivo e garante que não haja duplicatas. Normalmente, é representada por uma ou mais colunas. Exemplo:
    CREATE TABLE alunos (
      id_aluno INT PRIMARY KEY, /* Aqui */
      nome VARCHAR(50),
      idade INT
    );
    SQL
    • Chave Estrangeira (Foreign Key): Uma chave estrangeira estabelece uma relação entre duas tabelas. Ela geralmente corresponde à chave primária de outra tabela, criando um vínculo entre elas. Isso é crucial para manter a consistência nos dados. Exemplo:
    CREATE TABLE pedidos (
      id_pedido INT PRIMARY KEY,
      id_cliente INT,
      produto VARCHAR(50),
      FOREIGN KEY (id_cliente) REFERENCES clientes(id_cliente) /* Aqui */
    );
    SQL

    Estabelecendo Relacionamentos entre Tabelas:

    • Relacionamento Um para Um (One-to-One): Um registro em uma tabela está diretamente relacionado a apenas um registro em outra tabela e vice-versa. Por exemplo, uma tabela de funcionários e uma tabela de detalhes de contato.
    • Relacionamento Um para Muitos (One-to-Many): Um registro em uma tabela pode estar relacionado a vários registros em outra tabela. Este é o tipo mais comum de relacionamento. Por exemplo, uma tabela de clientes e uma tabela de pedidos.
    • Relacionamento Muitos para Muitos (Many-to-Many): Vários registros em uma tabela podem estar relacionados a vários registros em outra tabela. Isso é geralmente implementado por meio de uma tabela de junção. Exemplo, uma tabela de estudantes e uma tabela de cursos.

    O banco de dados fica do lado do servidor no contexto de “cliente-servidor”. Sendo assim, caso queira saber um pouco mais voce pode dar uma olhada nesta postagem onde eu explico sobre este topico:
    Entendendo o modelo cliente servidor na web.

    Conclusão

    Neste panorama inicial sobre bancos de dados para desenvolvimento web, exploramos conceitos fundamentais que servem como alicerce para estruturar e gerenciar dados de maneira eficiente. Compreender a importância dos bancos de dados no cenário do desenvolvimento web é crucial, pois eles formam a base sobre a qual aplicações interativas e dinâmicas são construídas.

    A transição da abordagem de armazenamento de dados, considerando arquivos versus bancos de dados, destaca a necessidade de uma solução mais organizada e escalonável. Ao adentrar o modelo relacional, visualizamos a estrutura de tabelas, registros e campos, que constitui a espinha dorsal dos bancos de dados modernos.

    A introdução à linguagem SQL tambem oferece um meio poderoso e legível para interagir com bancos de dados relacionais. Comandos como SELECT, INSERT, UPDATE e DELETE tornam-se ferramentas essenciais para manipular dados de forma eficaz.

    A exploração de chaves primárias e estrangeiras revela como estabelecer conexões significativas entre tabelas, promovendo integridade e consistência nos dados. Além disso, compreendemos diferentes tipos de relacionamentos, como um para um, um para muitos e muitos para muitos, destacando a flexibilidade e a adaptabilidade dos bancos de dados relacionais.

    À medida que avançamos, aprofundaremos tópicos como normalização, operações CRUD, indexação, otimização e segurança. Esses elementos, quando combinados, capacitam desenvolvedores a criar aplicações web robustas e eficientes, impulsionando a interatividade e a experiência do usuário.

    Para saber mais: O que é banco de dados